TokenMaxxing: เทคนิคใช้ AI ให้คุ้มค่าที่สุด ประหยัดงบพุ่งกระฉูด
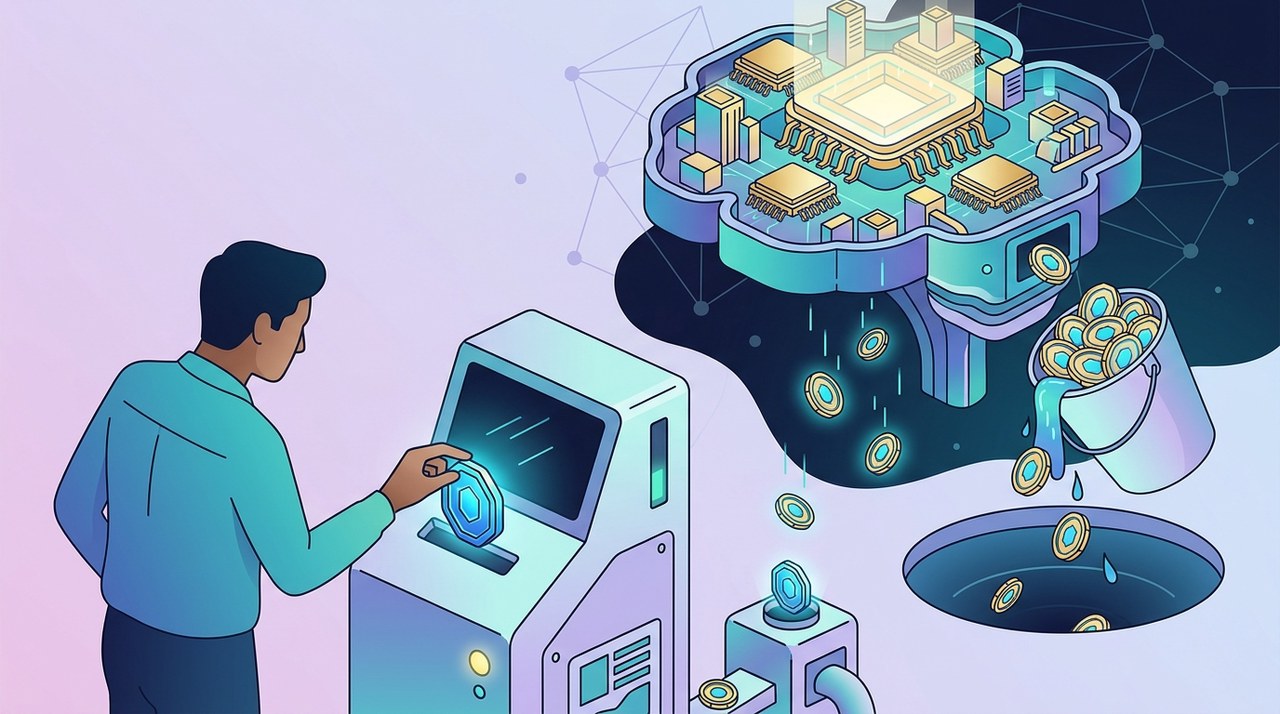
TokenMaxxing คืออะไร และทำไมคุณถึงต้องแคร์?
โมเดล AI ตัวท็อปอย่าง Claude Opus หรือ GPT รุ่นสูงๆ นั้นฉลาดและเก่งมากๆ ครับ แต่การเอาตัวท็อปพวกนี้มาใช้งานพื้นฐานทั่วไป ก็ไม่ต่างอะไรกับการจ้าง อัลเบิร์ต ไอน์สไตน์ มาช่วยคิดเงินทอนที่แมคโดนัลด์เลย
หลายคนติดนิสัยเลือกใช้โมเดล AI ตัวที่ใหญ่และแพงที่สุดกับทุกงานโดยไม่จำเป็น ซึ่งพฤติกรรมนี้แหละครับที่ทำให้บริษัทต้องแบกรับค่าบริการมหาศาล ส่วนผู้ใช้ทั่วไปที่สมัครรายเดือนก็เจอปัญหาใช้งานชนลิมิตเร็วเกินไป
ราคาที่ต้องจ่ายมหาศาลจากการใช้ Token แบบไม่วางแผน
ถ้าอยากรู้ว่าเงินของคุณหายไปไหน เราต้องมาดูวิธีคิดราคาของ AI กันก่อนครับ บริษัท AI จะคิดเงินตาม token ซึ่งเป็นชิ้นส่วนของข้อความ โดย 1 token จะยาวประมาณ 3 ใน 4 ของคำ
โมเดลระดับตัวท็อปจะมีราคาต่อ token แพงกว่าโมเดลขนาดเล็กสูงสุดถึง 100 เท่าเลยครับ โดยผู้ให้บริการ AI รายใหญ่จะมีราคาฝั่ง Input ตั้งแต่ $10 ไปจนถึงถูกสุดแค่ $0.10 ต่อ 1 ล้าน token เท่านั้น
อัตราการเผาเงินขององค์กรใหญ่
ช่วงต้นปี 2026 พนักงานของ Meta เพิ่งเผา token ของ AI ไปถึง 60 ล้านล้าน tokens ภายในเวลาแค่ 30 วันเท่านั้นครับ เพราะพวกเขากำลังแข่งกันทำคะแนนบนตารางผู้นำภายในองค์กรที่ตั้งชื่อเล่นกันว่า "Claudeonomics"
Gergely Orosz คอลัมนิสต์ด้านเทคโนโลยีประเมินว่า การใช้จ่ายอย่างบ้าคลั่งนี้คิดเป็นเงินสูงถึงประมาณ 900 ล้านดอลลาร์เมื่อเทียบกับราคาป้ายของ Anthropic แม้ว่า Meta น่าจะมีการต่อรองราคาระดับองค์กรไว้แล้วก็ตาม
Meta ไม่ใช่บริษัทเดียวที่ทำแบบนี้ครับ ทั้ง Microsoft, Shopify และ Amazon ต่างก็จัดตารางแข่งใช้ token ภายในบริษัทเช่นกัน ยิ่งไปกว่านั้น Jensen Huang ซีอีโอของ Nvidia ยังช่วยจุดกระแสนี้ในรายการพอดแคสต์ "All-In" เมื่อเดือนมีนาคม โดยกล่าวว่าเขาคงจะ "กังวลอย่างมาก" ถ้าวิศวกรที่มีค่าจ้าง 500,000 ดอลลาร์ ไม่ยอมใช้ token อย่างน้อย 250,000 ดอลลาร์
จึงไม่น่าแปลกใจเลยที่พนักงานเริ่มเผา token ไปกับงานไร้สาระที่ไม่เกิดประโยชน์ พนักงาน Amazon ยอมรับว่าแอบรันเครื่องมือ AI กับงานที่ไม่เกี่ยวข้องกัน เพียงเพื่อดันอันดับบนตารางแข่ง จนรองประธานบริหารต้องออกบันทึกเตือนอย่างจริงจังว่า "ได้โปรดอย่าใช้ AI เพียงเพราะแค่อยากใช้ AI เลย"
ในขณะเดียวกัน Uber ก็เผางบประมาณเครื่องมือ AI ของปี 2026 ทั้งปีหมดลงภายในเวลาเพียงสี่เดือน Jue Wang ที่ปรึกษาจาก Bain & Company ให้ความเห็นกับ Associated Press ว่า ผู้ใช้จำนวนมากมักเลือกใช้โมเดลตัวท็อปเป็นค่าเริ่มต้นโดยอัตโนมัติ แม้จะเป็นงานง่ายๆ อย่างการร่างอีเมลธรรมดาก็ตาม
พฤติกรรมการใช้จ่ายอย่างหนักหน่วงเหล่านี้อธิบายได้ดีว่าทำไมรายได้ต่อปีของ Anthropic ถึงพุ่งกระฉูดจากประมาณ 9 พันล้านดอลลาร์ ณ ปลายปี 2025 ไปสู่งทะลุ 47 พันล้านดอลลาร์ภายในเดือนพฤษภาคม ขณะที่ OpenAI ยังคงทำสงครามราคาอย่างดุเดือดเพื่อรักษาตำแหน่งในตลาด
ทำความเข้าใจอัตราค่าบริการมาตรฐานของ Anthropic
หากต้องการเห็นภาพว่าค่าใช้จ่าย token เพิ่มขึ้นทวีคูณได้อย่างไร ลองมาดูราคามาตรฐานต่อ 1 ล้าน tokens กันครับ:
- Haiku: Input $0.25 / Output $1.25 (สำหรับคำสั่งหรือ prompt ที่ต่ำกว่า 100,000 tokens ส่วน prompt ที่ยาวกว่านั้นจะแพงขึ้น 5 เท่า)
- Sonnet: Input $3.00 / Output $15.00
- Opus: Input $15.00 / Output $75.00
จะสังเกตได้ว่า Output tokens มีราคาแพงกว่า Input tokens ถึง 5 เท่าในทุกระดับ การคุมให้คำตอบของโมเดลตรงประเด็นและสั้นกระชับจึงช่วยประหยัดเงินได้เยอะมากครับ
AI Agents และ ระบบอัตโนมัติ ทำให้ค่าใช้จ่ายพุ่งสูงทวีคูณได้อย่างไร
กระบวนการทำงานยุคใหม่กำลังเปลี่ยนไปใช้ AI Agents แบบอัตโนมัติ ซึ่งมี 3 แนวคิดหลักที่ช่วยอธิบายว่าทำไมบิลค่าบริการของ AI agent ถึงบานปลายได้เร็วขนาดนี้
1. วงวนของ Agent (The Agent Loop)
Agent คือโมเดล AI ที่มีเครื่องมือพร้อมใช้งาน มันจะคิด ค้นหาข้อมูลบนเว็บ หรือรันโค้ด ตรวจสอบผลลัพธ์ แล้วก็วนลูปทำซ้ำไปเรื่อยๆ จนกว่าจะมองว่างานเสร็จสิ้น ซึ่งในทุกๆ ลูปที่วน มันจะส่งประวัติการสนทนาทั้งหมดกลับไปใหม่เสมอ ทำให้จำนวน token พุ่งขึ้นอย่างรวดเร็ว
2. การจัดระเบียบงานและ Subagents (Orchestration and Subagents)
ระบบที่ซับซ้อนจะใช้การจัดระเบียบงาน (Orchestration) โดยมีโมเดลผู้จัดการคอยย่อยคำสั่งแล้วส่งงานต่อให้โมเดลผู้ช่วยที่เรียกว่า Subagents ซึ่ง Subagent แต่ละตัวก็จะรันลูปของตัวเองพร้อมความจำแยกกัน Anthropic ระบุว่า ทีม agent ใน Claude Code ที่ทำงานในโหมดวางแผน (plan mode) สามารถกิน token ได้มากกว่าการแชทปกติถึงประมาณ 7 เท่า
3. เวิร์กโฟลว์แบบกราฟ (Graph Workflows)
เพื่อไม่ให้วงวนทำงานสะเปะสะปะไร้ทิศทาง นักพัฒนาจะใช้เฟรมเวิร์กอย่าง LangGraph ในการวางแผนผังเวิร์กโฟลว์คล้ายกับระบบรถไฟฟ้า โดยให้สถานี (Nodes) เป็นจุดทำงาน และรางรถไฟ (Edges) กำหนดทิศทางว่าคำขอต้องไปไหนต่อ ซึ่งเป็นการบังคับให้โมเดลเดินตามเส้นทางที่กำหนด แทนที่จะวนลูปไปเรื่อยๆ จนงบหมด
5 เคล็ดลับมือใหม่ช่วยลดค่าใช้จ่าย AI (ไม่ต้องเขียนโค้ดแม้แต่บรรทัดเดียว)
คุณไม่จำเป็นต้องเขียนโค้ดเป็นก็สามารถลดค่าใช้จ่าย token ได้ทันทีครับ และนี่คือ 5 นิสัยง่ายๆ ที่คุณเริ่มทำได้เลยในหน้าต่างแชท
เคล็ดลับที่ 1: เลือกโมเดลให้เหมาะกับงาน
กดเลือกโมเดลในแอปแชทของคุณ แล้วเปลี่ยนมาใช้ตัวเลือกที่เล็กกว่าและเร็วกว่าอย่าง Haiku หรือรุ่น mini สำหรับงานสรุปเนื้อหา ร่างอีเมล หรือเรียบเรียงข้อความใหม่ แล้วเก็บโมเดลตัวท็อปอย่าง Opus ไว้ใช้กับงานวิเคราะห์ซับซ้อนที่หากผิดพลาดเพียงนิดเดียวจะส่งผลกระทบอย่างจริงจัง
ลองเอา 5 งานประจำที่คุณทำบ่อยๆ มาทดสอบเปรียบเทียบกันระหว่างโมเดลเล็กและโมเดลตัวท็อปดูครับ ถ้าโมเดลเล็กทำได้ดีเหมือนกัน ก็ใช้โมเดลเล็กต่อไปได้เลย การเปลี่ยนมาใช้โมเดลขนาดเบาในแพ็กเกจ API สามารถช่วยลดค่าใช้จ่ายของคุณได้สูงสุดถึง 99%
เคล็ดลับที่ 2: เขียน Prompt ที่ดีรอบเดียว ดีกว่าเขียน Prompt แย่ๆ 5 รอบ
การส่งคำสั่งแก้ไขตามหลังเรื่อยๆ เช่น "ไม่เอา เอาแค่ยอดรวม" จะบังคับให้ AI ต้องอ่านข้อความทั้งหมดในแชทใหม่อีกรอบทุกๆ ครั้ง ดังนั้น ควรเขียน prompt ให้รายละเอียด ชัดเจน ระบุงานและโครงสร้างคำตอบที่ต้องการตั้งแต่แรกไปเลย
"ดึงข้อมูลเลขที่ใบแจ้งหนี้ วันที่ ผู้ขาย และยอดรวมจากข้อความด้านล่าง โดยคงค่าทุกอย่างไว้ให้ตรงตามต้นฉบับเป๊ะๆ แสดงผลลัพธ์บรรทัดละ 1 หัวข้อ และหากหาข้อมูลส่วนไหนไม่พบ ให้ระบุคำว่า 'missing'"
การทดสอบภายในของ OpenAI พบว่า prompt ที่กระชับและมีการจัดโครงสร้างที่ดี ช่วยให้ AI ตอบได้แม่นยำขึ้น แถมยังใช้ token น้อยลงด้วย
เคล็ดลับที่ 3: เปิดแชทใหม่เสมอเมื่อเปลี่ยนหัวข้อ
เนื่องจากโมเดลจะอ่านประวัติแชททั้งหมดใหม่ทุกครั้งที่คุณส่งข้อความ การถามเรื่องภาษีในแชทที่คุยเรื่องวางแผนเที่ยวแนวยาวเหยียด จึงทำให้การส่ง prompt แต่ละครั้งแพงขึ้นมากและทำให้ AI สับสนได้ง่าย
Anthropic เรียกภาวะที่ AI สูญเสียโฟกัสแบบนี้ว่า context rot (การเสื่อมของบริบท) ดังนั้นเมื่อไหร่ก็ตามที่จะเปลี่ยนหัวข้อ ให้เปิดห้องแชทใหม่ทันทีครับ
เคล็ดลับที่ 4: ระบุความยาวของคำตอบที่ต้องการ
เพราะ Output tokens ของโมเดลตัวท็อปมีราคาแพงกว่า Input tokens ถึง 5 เท่า ดังนั้นคุณควรกำหนดข้อจำกัดให้คำตอบสั้นกระชับอยู่เสมอ
ใส่คำสั่งเพิ่มเติม เช่น "สรุปมา 3 หัวข้อ ความยาวไม่เกิน 100 คำ" หรือ "ส่งกลับมาเฉพาะบรรทัดที่มีการแก้ไขเท่านั้น" การกำหนดขอบเขตคำตอบที่ชัดเจนจะช่วยป้องกันไม่ให้โมเดลใส่น้ำหรือเนื้อหาที่ไม่จำเป็นเข้ามา
เคล็ดลับที่ 5: ลองใช้ตัวเลือกฟรีก่อนตัดสินใจจ่ายเงิน
บริการอย่าง OpenRouter สามารถเชื่อมต่อไปยังโมเดลนับร้อยตัว และมีระบบเกาต์เส้นทางฟรีที่ช่วยส่งคำถามไปยังโมเดลที่ใช้งานได้ฟรีประมาณ 20 ตัว นอกจากนี้ คุณยังสามารถรันโมเดลบนเครื่องตัวเองได้ผ่านเครื่องมืออย่าง LM Studio หรือ Ollama หากคุณใช้ Mac ตระกูล M-series หรือมีการ์ดจอที่มี VRAM ขนาด 8GB ขึ้นไป
แพลตฟอร์มอย่าง Hermes และ Nvidia มีการรวบรวมโมเดลฟรีดีๆ ไว้มากมาย แม้ว่าคุณจะไม่ควรสร้างระบบสำคัญไว้บนบริการฟรีที่อาจปิดตัวลงเมื่อไหร่ก็ได้ แต่การซ้อมเขียน prompt บนสายฟรีจะช่วยให้คุณปรับแต่งงานให้เข้าที่ก่อนที่จะเสียเงินจริง และอย่าลืมตรวจสอบนโยบายความเป็นส่วนตัวเสมอถ้านำข้อมูลสำคัญไปใช้
เทคนิคทางลัดเพิ่มเติมสำหรับมือใหม่
- ปิดการคิดแบบขยาย (Extended Thinking): ให้ปิดโหมดความคิดแบบขยายสำหรับคำถามพื้นฐาน หรือลดค่าระดับความพยายาม (effort settings) ในโมเดลรุ่นใหม่ๆ เพราะ Anthropic คิดเงินกระบวนการคิดวิเคราะห์ทั้งหมดในฐานะ Output tokens—ซึ่งนับรวมขั้นตอนที่ซ่อนอยู่ไม่ให้เราเห็นด้วย
- ตั้งจำกัดงบค่าใช้จ่าย: ผู้ใช้แพ็กเกจ Claude Pro หรือ Max ที่ใช้เครดิตการใช้งาน สามารถตั้งขีดจำกัดค่าใช้จ่ายต่อเดือนอย่างเข้มงวดได้ที่ Settings > Usage
เคล็ดลับระดับกลาง: ป้องกันไม่ให้ AI Agent อ่านข้อมูลเกินจำเป็น
สำหรับนักพัฒนาที่ใช้ Agent บนเทอร์มินัลอย่าง Claude Code ของ Anthropic ตัว Agent อาจเผาทรัพยากรไปอย่างรวดเร็วจากการแสกนไฟล์ที่ไม่เกี่ยวข้อง
เคล็ดลับที่ 6: เริ่มต้นด้วยของถูก แล้วค่อยอัปเกรดเมื่อทำงานไม่ผ่าน
ใช้คำสั่ง `/model` เพื่อตั้งให้ Sonnet เป็นค่าเริ่มต้น และอัปเกรดเป็น Opus ต่อเมื่อ Sonnet ทำงานนั้นล้มเหลวติดต่อกัน 2 ครั้งเท่านั้น สำหรับงานเบื้องหลังง่ายๆ ให้ตั้งค่า `model: haiku` ในไฟล์การตั้งค่าของ subagent
เคล็ดลับที่ 7: ล้างประวัติการคุยเมื่อเปลี่ยนงาน
พิมพ์คำสั่ง `/clear` เมื่อต้องการเปลี่ยนไปทำงาที่ไม่เกี่ยวข้องกัน เพื่อลบประวัติเก่าออกได้ฟรีๆ
ถ้าจำเป็นต้องเก็บรายละเอียดสำคัญไว้ ให้ใช้คำสั่ง `/compact` ร่วมกับคำสั่งเฉพาะ เช่น `/compact keep the database decisions` อย่างไรก็ตาม ควรใช้การย่อขนาด (compaction) เท่าที่จำเป็น เพราะตัวกระบวนการย่อขนาดเองก็ถือเป็นการส่งคำขอไปยัง AI เช่นกัน
เคล็ดลับที่ 8: ปล่อยให้โค้ดจัดการเรื่องคำนวณ
การวางไฟล์สเปรดชีต 5,000 แถวลงในแชท จะบังคับให้ AI ต้องอ่านข้อความหลายพันบรรทัด แถมยังอาจจะนับเลขผิดได้อีกด้วย เพราะโมเดล AI ถูกสร้างมาเพื่อประมวลผลภาษา ไม่ใช่เครื่องคิดเลขเฉพาะทาง
เปลี่ยนเป็นสั่งให้โมเดลเขียนสคริปต์สั้นๆ หรือสูตรคำนวณแทน แล้วเอารันโค้ดนั้นบนเครื่องของคุณเอง จากนั้นค่อยส่งเฉพาะผลลัพธ์สุดท้ายกลับไปให้โมเดล
เคล็ดลับที่ 9: ตัดเครื่องมือ MCP ที่ไม่ได้ใช้ออก
เซิร์ฟเวอร์ Model Context Protocol (MCP) จะเชื่อมต่อเครื่องมือต่างๆ เช่น GitHub หรือ Google Drive เข้ากับ Agent ของคุณ ทว่าปลั๊กอินแต่ละตัวที่เชื่อมต่อ จะแอบแนบชื่อเครื่องมือและคำสั่งประกอบลงไปในหน้าต่าง prompt ทุกๆ ครั้ง
ใช้คำสั่ง `/context` เพื่อตรวจสอบว่าอะไรกำลังกินหน่วยความจำอยู่ และใช้ `/mcp` เพื่อปิดการทำงานของปลั๊กอินที่ไม่ใช้ Anthropic แสดงให้เห็นว่าการตัดคำอธิบายเครื่องมือที่ไม่จำเป็นออก ช่วยลดการใช้ token ของ agent ลงจาก 150,000 เหลือเพียง 2,000 tokens เท่านั้น
เทคนิคทางลัดเพิ่มเติมระดับกลาง
- ติดตามการใช้งาน: พิมพ์คำสั่ง `/usage` เป็นประจำเพื่อตรวจสอบจำนวน token ที่ใช้อย่างแม่นยำ
- เขียนคำสั่งให้กระชับ: ควบคุมให้ไฟล์บริบทของโปรเจกต์ เช่น `CLAUDE.md` หรือ `Soul.md` มีความยาวไม่เกิน 200 บรรทัด
- ใช้โหมดวางแผน (Plan Mode): กด `Shift+Tab` เพื่อเข้าสู่โหมดวางแผนก่อนสั่งแก้ไขไฟล์ใหญ่ๆ ตรวจสอบแผนงานของ agent ก่อนล่วงหน้า แล้วกด `Esc` หากเห็นว่ามันเริ่มออกนอกเส้นทาง
- ลดระดับความพยายาม: ใช้คำสั่ง `/effort` เพื่อลดระดับการวิเคราะห์ลงสำหรับงานง่ายๆ เช่น การเปลี่ยนชื่อตัวแปร
ระบบการป้องกันระดับสูงสำหรับนักพัฒนา
ลองจินตนาการถึงการประมวลผลใบแจ้งหนี้ 1,000 ใบ ซึ่งแต่ละใบมีขนาดเฉลี่ย 2,000 tokens เพื่อให้ได้คำตอบความยาว 200 tokens งานพื้นฐานนี้จะมีค่าใช้จ่ายประมาณ $30 บน Fable 5.1 เมื่อเทียบกับเพียง $0.30 บน Haiku 5.5—และนี่ยังไม่ได้ใช้เทคนิคขั้นสูงใดๆ เลยด้วยซ้ำ
เคล็ดลับที่ 10: ทำ Caching ให้กับคำสั่งประจำ
วาง prompt ที่ไม่มีการเปลี่ยนแปลงไว้ส่วนแรก แล้วเปิดใช้งาน Prompt Caching ใน API ของ Anthropic ทำได้โดยการเพิ่มฟิลด์พิเศษเข้าไปใน request body:
"system": [{"type": "text", "text": "Your invoice instructions...", "cache_control": {"type": "ephemeral"}}]
การอ่านบริบทจากแคช (Cache) จะคิดราคาเพียงเศษเสี้ยวของราคา Input ปกติ แม้ว่าการเขียนลงแคชชั่วคราวแบบ 5 นาทีจะมีค่าธรรมเนียมเริ่มต้นเล็กน้อยก็ตาม คุณสามารถเช็กฟิลด์ `cache_read_input_tokens` ในผลลัพธ์ตอบกลับของ API เพื่อยืนยันว่าระบบแคชกำลังทำงานอยู่
เคล็ดลับที่ 11: ส่งงานที่ไม่รีบแบบเป็นชุด (Batch Requests)
ทั้ง OpenAI และ Anthropic มีส่วนลด 50% สำหรับการส่งคำขอแบบเป็นชุด (Batch Requests) โดย OpenAI รับประกันผลลัพธ์ภายใน 24 ชั่วโมง การส่งใบแจ้งหนี้ 1,000 ใบในไฟล์แบบ batch เดียวจะช่วยหั่นค่าใช้จ่ายลงครึ่งหนึ่งทันที
เคล็ดลับที่ 12: ใส่สายสืบล็อกขอบเขตการทำงานของ Agent
กำหนดเงื่อนไขการหยุดที่ชัดเจน ตั้งค่าจำนวนขั้นตอนสูงสุด และจำกัดงบประมาณในทุกการรันระบบอัตโนมัติ Claude Code รองรับการใช้พารามิเตอร์ `--max-budget-usd` สำหรับการรัน agent ผ่านสคริปต์
บริษัทอย่าง Shopify มีการติดตั้งระบบตัดไฟอัตโนมัติ (Circuit Breakers) ที่จะตัดการเข้าถึงของนักพัฒนาทันทีหากพบว่ามีการใช้จ่ายพุ่งสูงผิดปกติภายในวันเดียว เพื่อป้องกันไม่ให้ลูปรันไปเรื่อยๆ จนงบบานปลาย
เทคนิคทางลัดเพิ่มเติมสำหรับระดับสูง
- จัดวางข้อมูลสำคัญอย่างมีกลยุทธ์: วางรายละเอียดสำคัญไว้ตอนเริ่มต้นหรือท้ายสุดของ prompt ที่ยาวเหยียด ผลการศึกษาจาก Stanford พบว่า โมเดลจะมีปัญหามากที่สุดในการดึงข้อมูลที่ซ่อนอยู่ตรงกลาง
- ตรวจสอบเฉพาะจุดที่จำเป็น: ใช้โมเดลตัวที่สองเข้ามาช่วยตรวจสอบความถูกต้องเฉพาะในงานที่มีความเสี่ยงทางการเงินสูงเท่านั้น เช่น การตรวจสัญญาทางกฎหมาย หรือตัวเลขการชำระเงิน
- ตั้งค่าขีดจำกัดสูงสุดของ API: กำหนดจำกัดงบประมาณสูงสุดที่เด็ดขาดในแดชบอร์ด API ของ OpenAI เพราะระบบแจ้งเตือนทางอีเมลแบบปกติจะทำแค่แจ้งเตือน แต่ไม่ได้ตัดการทำงานจริง
พาราด็อกซ์ของเจวอนส์ (Jevons Paradox): ทำไม AI ราคาถูกลง แต่เรากลับจ่ายแพงขึ้น
หากต้องการทดสอบเทคนิคเหล่านี้ ลองตั้งค่าโมเดลที่ถูกที่สุดซึ่งทำงานได้เป็นค่าเริ่มต้นสัก 1 สัปดาห์ แล้วเปรียบเทียบค่าใช้จ่ายทั้งหมดดู ในแบบทดสอบใบแจ้งหนี้ 1,000 ใบ การส่งงานไปยังโมเดลที่เหมาะสมสามารถลดค่าใช้จ่ายทั้งหมดจาก $30 เหลือเพียง $3.90—แม้ว่าจะต้องจ่ายเงินให้ Opus 5.5 ช่วยแก้ทำงานที่ไม่ผ่าน 300 รายการใหม่ด้วยก็ตาม
ที่น่าสนใจก็คือ ราคาต่อ token ที่ถูกลง กลับไม่ได้ช่วยลดค่าใช้จ่าย AI ในภาพรวมเลย ดัชนี Token Expenditure Index ของ Silicon Data แสดงให้เห็นว่า ราคาต่อ token ลดลงมากกว่า 90% ตั้งแต่ปี 2023 แต่การใช้จ่ายโดยรวมกับโมเดลภาษาขนาดใหญ่กลับเพิ่มขึ้นเป็นสองเท่าตั้งแต่ปลายปี 2025
นักเศรษฐศาสตร์เรียกปรากฏการณ์นี้ว่า Jevons paradox เมื่อทรัพยากรใดทรัพยากรหนึ่งมีราคาถูกลงและมีประสิทธิภาพมากขึ้น ยอดการใช้งานรวมจะพุ่งสูงขึ้น เพราะผู้คนจะเริ่มนำมันไปประยุกต์ใช้กับงานต่างๆ มากขึ้นอย่างมหาศาล
รายงานสรุปจาก Bain & Company เมื่อเดือนมิถุนายนยืนยันแนวโน้มนี้เช่นกัน โดยพบว่า แม้ราคาเฉลี่ยต่อ token จะลดลงครึ่งหนึ่งระหว่างเดือนธันวาคม 2024 ถึงธันวาคม 2025 แต่ปริมาณการใช้ token ทั้งหมดกลับเติบโตสูงถึง 450%
ราคาที่ลดลงจะเป็นประโยชน์กับคุณทันทีที่คุณหยุดใช้ token อย่างสิ้นเปลือง เพียงแค่ปรับใช้นิสัย TokenMaxxing เหล่านี้ เวิร์กโฟลว์ AI ของคุณก็จะมีราคาถูกลงอย่างมาก แถมยังทำงานได้มีประสิทธิภาพมากขึ้นไปพร้อมๆ กันครับ
บทความล่าสุด


ตลาด Ethereum ส่งสัญญาณก้ำกึ่ง ขณะที่ความผันผวนยังคงอยู่
ตลาดอนุพันธ์ Ethereum แสดงภาพรวมที่ซับซ้อน โดย Open Interest ของ Futures ยังคงยืนเหนือ 3 หมื่นล้านดอลลาร์ ขณะที่การล้างพอร์ตฝั่ง Long ปรับตัวสูงขึ้น
|

Solana เครือข่ายรันต่อเนื่องครบ 2 ปี พร้อมส่องความเสี่ยงจากรายงาน Fidelity
Solana ทำสถิติรันเครือข่าย mainnet ได้ต่อเนื่อง 2 ปีโดยไม่ล่มเลย แต่ Fidelity ชี้ว่ายังมีบางจุดสำคัญที่ต้องจับตาดูอย่างใกล้ชิด
|

David Schwartz เตือนสายคริปโต ระวังกลโกงแอปกระเป๋า SecuX
David Schwartz อดีต CTO ของ Ripple ออกเตือนด่วน หลังเจอกลโกงการแจ้งเตือนบนมือถือที่มุ่งหลอกเอา Seed Phrase ของผู้ใช้
|